Uma equipe de produto lança um assistente de IA. O painel mostra que a maioria das respostas recebe polegar para cima e poucas são regeneradas. A conclusão parece óbvia: os usuários entendem o que o assistente explica. Essa conclusão não se sustenta, e o motivo está em um fenômeno que a linguística descreve há mais de cinquenta anos.
Este texto parte da pergunta prática (como saber se o usuário acompanhou a resposta) e volta à teoria apenas quando ela ajuda a responder.
Por que a taxa de aceitação não indica que o usuário entendeu?
Porque aceitar é uma decisão final de um clique, enquanto entender e verificar são trabalhos que o clique não registra. Uma taxa alta pode conviver com pouca compreensão.
O caso mais bem documentado vem da programação assistida. Mozannar, Bansal, Fourney e Horvitz (CHI 2024, a principal conferência de interação humano–computador) acompanharam 21 programadores usando o GitHub Copilot. Das 1.024 sugestões registradas, 34% foram aceitas, com grande variação entre pessoas. Verificar a sugestão esteve entre os estados que mais consumiram tempo de sessão.
Os mesmos autores, na AAAI 2024, alertam que otimizar a exibição de sugestões pela aceitação pode piorar a qualidade do que é mostrado. Em outras palavras: a métrica mais fácil de coletar é também a mais fácil de enganar.
Um fenômeno análogo aparece com fontes em respostas de chat: a presença da citação eleva a confiança sem elevar a conferência. Tratamos desse caso em “ChatGPT com fontes: por que quase ninguém confere”.
O que é backchannel e de onde vem o termo?
Backchannel é o conjunto de sinais curtos que o ouvinte emite enquanto o outro fala, sem tomar a palavra: “uhum”, “sim”, um aceno, um olhar atento. O termo foi proposto pelo linguista Victor Yngve em 1970, no artigo “On getting a word in edgewise”.
Yngve observou que, em uma conversa, quem tem o turno e quem escuta estão falando e ouvindo ao mesmo tempo. O falante recebe pelo “canal de trás” mensagens como “yes” e “uh-huh”, e isso não interrompe o turno.
Para quem desenha produto, a consequência é concreta. O falante usa esse retorno para ajustar o que diz em tempo real. Sem ele, quem explica precisa adivinhar.
Como o backchannel se relaciona com grounding?
O backchannel é uma das principais fontes de evidência para o grounding, o processo de construir entendimento compartilhado descrito por Herbert Clark e Susan Brennan em 1991. O critério do grounding não é a compreensão total, mas a compreensão suficiente para o propósito do momento.
Clark e Brennan mostram que cada meio de comunicação altera o custo desse processo. Conversa presencial oferece copresença, visibilidade e simultaneidade, portanto evidência contínua de atenção. Texto escrito oferece a possibilidade de reler e revisar, mas pouca evidência de que o leitor acompanha naquele instante.
Por que o chat de IA perdeu esse canal?
Porque o modelo entrega cada resposta como um bloco fechado e só recebe retorno quando o usuário age explicitamente. Não há meio de emitir um “uhum” no terceiro parágrafo.
Os produtos atuais compensam parcialmente. Em voz, interfaces em tempo real aceitam interrupção e emitem confirmações curtas. Em texto, há botão de parar, regeneração, avaliação por polegar, correção durante a geração em modos de raciocínio e pedido de confirmação antes de ações de agente.
Todos esses mecanismos exigem iniciativa do usuário. Não encontramos, em produtos de uso geral, um sinal publicado de acompanhamento da leitura que dispense essa iniciativa.
Quais sinais podem indicar que o usuário está acompanhando?
Nenhum sinal isolado prova compreensão; cada um é evidência fraca que precisa ser validada. A lista abaixo vai do mais barato ao mais invasivo:
| Sinal | O que pode indicar | Cuidado |
|---|---|---|
| Pausa sem rolagem em um trecho | Leitura atenta ou dificuldade | Também pode ser distração |
| Seleção ou cópia de uma frase | Foco, intenção de uso | Copiar não é entender |
| Botão de parar durante a geração | Resposta longa ou fora do rumo | Pode ser pressa |
| Regeneração repetida | Insatisfação com a forma ou o conteúdo | Não diz o que faltou |
| Pergunta de esclarecimento no turno seguinte | Lacuna de compreensão | Exige texto do usuário |
| Expandir ou recolher seções | Interesse por detalhe ou excesso | Depende de resposta em esqueleto |
| Teach-back opcional | Verificação direta da meta | Fricção; usar só em alto risco |
| Expressão facial via câmera, com consentimento | Sobrecarga ou pausa | Privacidade, viés, falso positivo |
Para validar qualquer desses sinais, compare-o com medidas diretas em teste controlado: perguntas de compreensão após a leitura, respostas com erros plantados e autorrelato de esforço.
A câmera pode devolver o backchannel ao texto?
Pode ser testada como hipótese, não afirmada como solução. A viabilidade técnica mudou em 2026 com os modelos de decisão, que não escrevem texto e respondem apenas com probabilidade, escolha entre opções ou nota.
Dois exemplos verificados:
- Decisions API (OpenAI): em beta pública, com o modelo
gpt-6-luna, avalia texto, imagens ou ambos. As imagens são enviadas em base64. - Jev (TypeSafe AI): responde perguntas tipadas com probabilidades calibradas, mas a entrada documentada é apenas textual (linguagem natural, código, dados estruturados). Não serve, hoje, para classificar imagens.
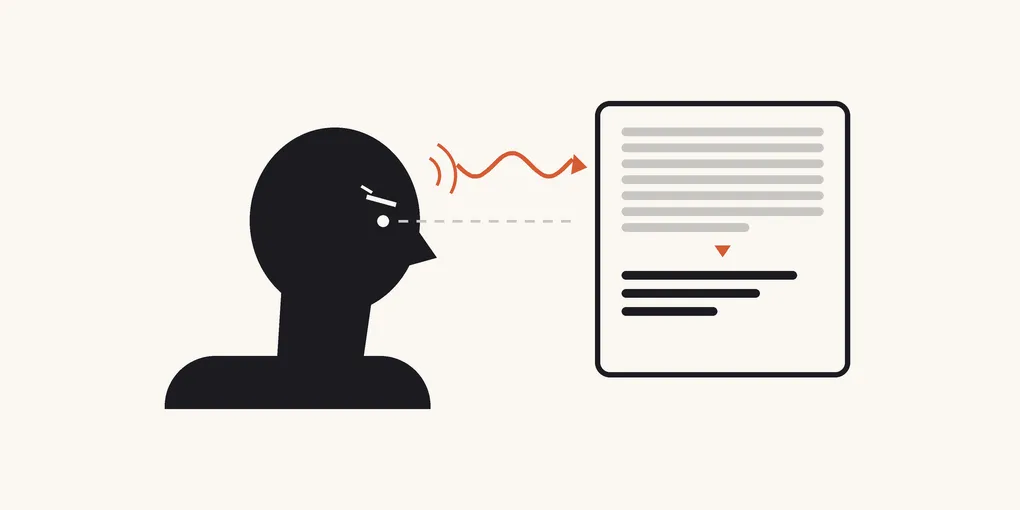
Um protótipo possível: com consentimento explícito, quadros esparsos da câmera são enviados a um modelo de decisão que responde “o leitor parece sobrecarregado?”. Acima de um limiar, o chat passa a oferecer um esqueleto da resposta com detalhes sob demanda.
A ideia dialoga com as interfaces cérebro-computador passivas (Zander e Kothe, 2011), que adaptam sistemas ao estado do usuário a partir de sinais neurofisiológicos. A câmera é um sensor mais acessível, porém mais indireto. Não conhecemos estudo que valide expressão facial como medida de compreensão de leitura em chats com IA.
Quais cuidados são obrigatórios antes de testar?
- Consentimento: recurso opcional, desligado por padrão, revogável a qualquer momento.
- Privacidade: processamento local ou retenção zero; nenhum quadro armazenado; indicador visível de câmera ativa.
- Falso positivo: concentração pode ser lida como confusão; toda adaptação deve ser reversível pelo usuário.
- Viés: medir desempenho por grupo demográfico, cultura e condição de iluminação.
- Finalidade: o sinal não pode ser reaproveitado para vigilância, avaliação de desempenho ou publicidade.
Perguntas frequentes
Backchannel e feedback são a mesma coisa?
Não. Feedback, em produto, costuma ser uma avaliação explícita e posterior (polegar, nota). Backchannel é contínuo, simultâneo à fala e não interrompe o turno.
O polegar para cima serve como sinal de compreensão?
Serve como sinal de satisfação declarada, não de compreensão. A pessoa pode aprovar uma resposta que não leu inteira.
É possível medir compreensão sem câmera?
Sim, de forma aproximada, combinando sinais de interação (pausas, seleção, parada, perguntas de esclarecimento) e validando-os contra testes de compreensão.
O Jev pode analisar imagens?
Não, segundo a documentação disponível em outubro de 2026: a entrada é textual. A Decisions API da OpenAI aceita imagens.
Onde ler a versão resumida para LinkedIn?
O artigo complementar está no LinkedIn: Leia o artigo no LinkedIn.
Se o seu produto já mede acompanhamento de alguma forma, ou ainda depende da taxa de aceitação, converse comigo no LinkedIn.
Referências
- Yngve, V. H. (1970). On getting a word in edgewise. Papers from the Sixth Regional Meeting of the Chicago Linguistic Society, 567–578. Registro: https://mpipsyl.disco.mpg.de/Record/MPIPL_cat.PL0021481/DetailsIndex
- Clark, H. H., & Brennan, S. E. (1991). Grounding in communication. In L. B. Resnick, J. M. Levine, & S. D. Teasley (Eds.), Perspectives on socially shared cognition (pp. 127–149). APA. https://doi.org/10.1037/10096-006
- Mozannar, H., Bansal, G., Fourney, A., & Horvitz, E. (2024). Reading between the lines: Modeling user behavior and costs in AI-assisted programming. CHI 2024. https://doi.org/10.1145/3613904.3641936
- Mozannar, H., Bansal, G., Fourney, A., & Horvitz, E. (2024). When to show a suggestion? Integrating human feedback in AI-assisted programming. AAAI 2024. https://ojs.aaai.org/index.php/AAAI/article/view/28878
- Zander, T. O., & Kothe, C. (2011). Towards passive brain–computer interfaces. Journal of Neural Engineering, 8(2). https://doi.org/10.1088/1741-2560/8/2/025005
- OpenAI. Decisions (guia da API). https://developers.openai.com/api/docs/guides/decisions
- TypeSafe AI. Introducing System One Models & Jev. https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Pydantic AI. TypeSafe (Jev). https://pydantic.dev/docs/ai/models/typesafe/